Cuando pensamos en un ordenador, imaginamos transistores, impulsos eléctricos y una secuencia de instrucciones ejecutándose a toda velocidad. Un trabajo publicado el 16 de septiembre de 2026 en Nature propone una imagen bastante distinta: cadenas de ADN dentro de una disolución, compitiendo por ocupar posiciones en una estructura hasta que la configuración más estable representa la respuesta correcta.
El sistema se llama Scaffolded DNA Computer (SDC), que podemos traducir como ordenador de ADN con andamiaje. Sus autores, de la Universidad de Maynooth, han ejecutado más de 700 cálculos correspondientes a diez programas. Entre ellos hay sumas, multiplicaciones, divisiones, detección de paridad, reconocimiento de paréntesis equilibrados y búsqueda de caminos en grafos.
El avance es serio y muy sugerente, pero conviene colocar bien la lupa. No estamos ante un procesador biológico que vaya a sustituir al silicio, ni ante un dispositivo que calcule mágicamente «sin energía». Es una demostración experimental de otra forma de computar: diseñar un sistema físico para que la respuesta correcta coincida con su estado energéticamente más favorable.
La idea central: dejar que la física busque la respuesta
Los ordenadores digitales convencionales se mantienen lejos del equilibrio termodinámico. Necesitan energía para cambiar el estado de sus transistores, conservar señales distinguibles y evitar o corregir errores. Lo mismo ocurre en muchos sistemas biológicos y en buena parte de la computación molecular previa: el resultado deseado se sostiene mediante procesos activos, redundancia o secuencias cuidadosamente controladas.
El SDC invierte ese planteamiento. El programa se diseña de manera que el resultado correcto sea también la configuración de menor energía libre. En vez de empujar continuamente al sistema por una ruta estricta, se permite que las moléculas se unan, se separen y sustituyan unas a otras mientras la mezcla se aproxima al equilibrio.
Una analogía sencilla sería una caja con piezas magnéticas. Si cada encaje correcto reduce la energía del conjunto y cada incompatibilidad deja una unión menos favorable, al agitar la caja durante el tiempo suficiente las piezas tenderán a reorganizarse hasta formar la estructura prevista. La diferencia, naturalmente, es que aquí las reglas están codificadas en secuencias de ADN y las piezas tienen escala molecular.
💡 Tip técnico: cuando leas «computación sin energía», busca la frontera del sistema que se está midiendo. El cálculo molecular puede aprovechar una relajación espontánea, pero preparar las cadenas, calentar y enfriar la muestra, manipular líquidos y leer fluorescencia sí requiere equipamiento y energía.
Cómo está construido el ordenador de ADN
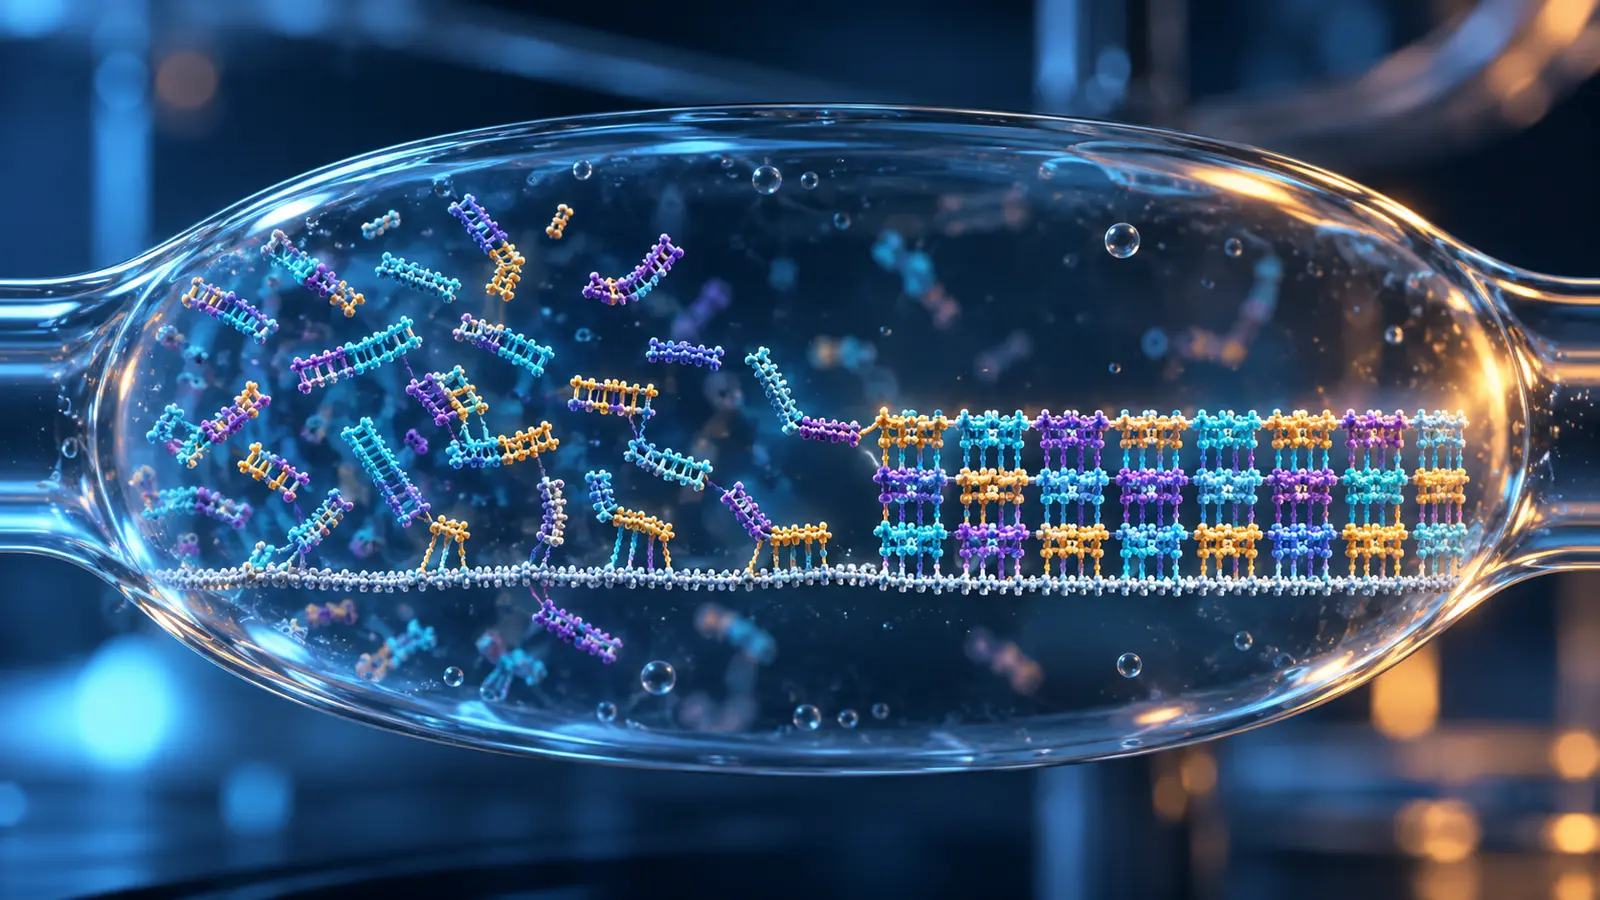
La arquitectura parte de una cadena larga de ADN que funciona como andamiaje. Esa cadena contiene una sucesión de posiciones únicas. Sobre ellas compiten cadenas más cortas, denominadas teselas o tiles, que codifican tanto datos como reglas del programa.
Cada tesela reconoce su posición en el andamiaje mediante una región central y se relaciona con sus vecinas mediante dominios laterales. Si dos teselas adyacentes son compatibles, sus dominios forman una unión más estable. Si no lo son, aparece una penalización energética y alguna de ellas puede ser reemplazada. Según el artículo, las cadenas competidoras se añaden normalmente en exceso respecto al andamiaje para que todas las posiciones puedan ocuparse.
El proceso experimental más común fue un recocido: calentar la mezcla y reducir progresivamente la temperatura. En los ensayos pequeños, la temperatura bajó de 80 a 20 grados durante tres horas. El calor permite deshacer configuraciones débiles y el enfriamiento favorece que el conjunto se reorganice. Para instancias cortas también probaron recocidos de un minuto e incluso de unos treinta segundos.
El resultado se leyó mediante fluorescencia. Una señal baja representaba un 0 y una alta, un 1. Por tanto, no había una pantalla microscópica mostrando números: cada bit de salida debía consultarse con cadenas informadoras y medidas de laboratorio.
💡 Tip técnico: en computación no convencional hay que separar siempre cuatro etapas: codificación de la entrada, ejecución física, lectura de la salida y posibilidad de reutilización. Un núcleo experimental puede ser elegante y eficiente mientras la entrada o la lectura siguen siendo lentas y costosas.
Qué programas logró ejecutar
La demostración no se limita a una sola operación preparada a medida. Los investigadores construyeron un lenguaje de teselas y compilaron distintas máquinas de estados finitos, una clase de programa que avanza entre estados según los símbolos que recibe.
En una suma binaria, por ejemplo, cada posición combina dos bits de entrada con el acarreo procedente de la posición anterior. La tesela elegida representa a la vez el bit de salida y el nuevo acarreo. El artículo muestra el cálculo de 10 + 3 = 13 y otras sumas con un andamiaje de cuatro posiciones.
Los diez programas incluyen copia de bits, detección de paridad de ocho bits, multiplicación por tres, división por dos en base ternaria, un autómata no determinista, un contador, la regla 110, reconocimiento de paréntesis equilibrados y alcance en grafos. Es una selección interesante porque demuestra lógica secuencial, resultados binarios y ternarios, y más de una clase de problema.
En los sistemas cortos, los recocidos habituales alcanzaron un rendimiento medio del 95,3 % frente a los controles definidos por el equipo. Los recocidos de un minuto redujeron la cifra media a alrededor del 81 %, aunque las salidas continuaron siendo separables mediante un umbral específico para cada programa. Son resultados de laboratorio medidos con su propio procedimiento, no una tasa de precisión directamente comparable con la de una CPU.
💡 Tip técnico: una cifra de «rendimiento» solo tiene sentido junto con su definición. Aquí describe cuánto se aproxima la señal experimental a unos controles de referencia. No significa que el sistema complete arbitrariamente el 95,3 % de cualquier cálculo posible.
El cálculo de 100 bits y la cuestión de la escala
El titular más llamativo es el cálculo de 100 bits. Se trató de sumar dos números de 25 bits sobre un andamiaje de 25 posiciones. Los autores cuentan 25 bits de cada entrada, 25 de acarreo y 25 de salida. Es una prueba bastante mayor que las instancias de cuatro posiciones, pero no equivale a un procesador de 100 bits en el sentido habitual.
La ampliación también mostró dónde empiezan las dificultades. Las distintas secuencias del ADN no tienen exactamente la misma energía de unión, pueden aparecer interacciones no deseadas y una cadena biológica larga incluye regiones que no participan en el cálculo. El equipo tuvo que rediseñar el paisaje energético, introducir mecanismos para absorber acarreos erróneos y seleccionar una región de 624 bases del ADN del fago M13.
La copia a lo largo de 25 posiciones necesitó un recocido de 14 horas y alcanzó un rendimiento del 59 %. En otras palabras, el experimento respalda la escalabilidad matemática del enfoque y demuestra una ampliación física, pero también deja claro que el salto desde unas pocas posiciones hasta sistemas grandes no está resuelto.
💡 Tip técnico: no confundas el tamaño de la representación con la capacidad general del sistema. «100 bits de cómputo» describe la complejidad contabilizada de un experimento concreto; no sus registros, memoria, frecuencia o repertorio de instrucciones.
Reprogramable y reutilizable, con matices
Una propiedad especialmente interesante es que la misma muestra puede volver a utilizarse. Para cambiar la entrada, el equipo añadió cadenas nuevas y bloqueadores complementarios de la entrada anterior, y después repitió el recocido. Un programa de copia alternó entre 0 y 1 durante 25 ejecuciones; otros programas de suma y contador también se renovaron varias veces.
Esto no convierte la probeta en un ordenador de propósito general. El programa sigue dependiendo del conjunto de cadenas disponibles y cada renovación añade material, modifica concentraciones y requiere otro ciclo térmico. Aun así, demuestra que la estructura no es necesariamente de un solo uso y abre una vía hacia soportes moleculares que almacenen y transformen información en el mismo medio.
El equipo ha publicado además los datos y el código asociados. Esa disponibilidad permite examinar el diseño, reproducir análisis y distinguir mejor el resultado experimental de las interpretaciones más ambiciosas.
💡 Tip técnico: ante una demostración científica novedosa, comprueba tres capas de evidencia: artículo revisado, datos o código reutilizables y repetición independiente. Este trabajo cumple bien las dos primeras; la validación por otros laboratorios será el siguiente paso importante.
Lo que este avance no significa
No sustituye a los chips de silicio
Una suma que una CPU resuelve en una fracción diminuta de segundo puede exigir aquí desde decenas de segundos hasta horas, además de síntesis molecular, control térmico y lectura óptica. El SDC no pretende competir con un portátil, una GPU o un servidor en tareas generales.
No es computación cuántica
Que el comportamiento dependa de energía, probabilidad y moléculas no convierte el dispositivo en un ordenador cuántico. No usa qubits, superposición ni puertas cuánticas. Es computación molecular clásica guiada por termodinámica. En nuestro artículo sobre computación cuántica y futuro híbrido explicábamos precisamente por qué conviene diferenciar una arquitectura física especializada de otra.
No funciona literalmente sin aporte energético
La relajación hacia el equilibrio es el motor conceptual de la computación, pero el experimento parte de moléculas sintetizadas, usa ciclos de temperatura, manipulación automatizada y una máquina PCR para medir fluorescencia. La afirmación rigurosa es que el resultado se hace termodinámicamente favorable y evita mantenerlo mediante un proceso activo de corrección, no que el sistema completo tenga consumo cero.
No demuestra todavía una aplicación dentro de células
Los autores mencionan que los ordenadores moleculares podrían resultar útiles en entornos biológicos, materiales inteligentes o almacenamiento de ADN. Son direcciones plausibles de investigación, no aplicaciones demostradas por este trabajo. El experimento se realizó en disoluciones controladas y con instrumentación de laboratorio.
Por qué importa aunque no vaya a ejecutar tu software
Su valor no está en hacer mejor lo que ya hace el silicio. Está en mostrar que un programa puede incorporarse al paisaje energético de un material: la física del propio soporte participa en la búsqueda y corrección del resultado.
Eso podría ser útil allí donde la computación debe convivir con moléculas, donde el almacenamiento y el procesamiento necesiten estar estrechamente unidos o donde millones de copias puedan operar en paralelo dentro de volúmenes mínimos. También ofrece ideas para diseñar sistemas sintéticos que se autoorganicen y eliminen errores sin una secuencia externa de control para cada paso.
Esta lógica conecta con una tendencia más amplia: el futuro de la computación será probablemente heterogéneo. Igual que una IA científica especializada no reemplaza a todos los modelos, un ordenador molecular no necesita desplazar a la CPU para resultar valioso. Puede convertirse en un componente muy específico de un flujo mayor.
💡 Tip técnico: para valorar una tecnología emergente, pregunta qué entorno le concede una ventaja natural. En el caso del ADN no es la ofimática, sino la proximidad a procesos moleculares, el paralelismo masivo, la densidad de información y la posibilidad de unir almacenamiento y cálculo.
El ordenador de ADN presentado en Nature no anuncia el fin del silicio. Demuestra algo más concreto y, precisamente por eso, más interesante: una colección programable de moléculas puede ejecutar distintos algoritmos mientras se relaja hacia un equilibrio diseñado para favorecer la respuesta correcta.
Los más de 700 cálculos, los diez programas, las ejecuciones cortas por debajo de un minuto y la reutilización de muestras son avances medidos. También lo son las limitaciones: la lectura requiere instrumentación, la ampliación a 25 posiciones tarda horas, el rendimiento cae con la escala y las aplicaciones prácticas siguen abiertas.
La lección no es que pronto llevaremos una probeta en lugar de un portátil. Es que «computar» no tiene por qué significar siempre hacer circular corriente por transistores. A veces puede consistir en diseñar la materia para que, al buscar su estado más estable, encuentre también una respuesta.
Fuentes
- Stérin, T. et al. A thermodynamically favoured molecular computer, Nature 657, 646–652 (2026).
- Proyecto DISCO de la Universidad de Maynooth: explicación del Scaffolded DNA Computer.
- Stérin, T. et al. datos y código del trabajo, Zenodo.
Deja una respuesta