El aprendizaje federado nació con una promesa atractiva: entrenar modelos con información distribuida entre millones de dispositivos sin reunir todos esos datos en una base central. La idea sigue siendo valiosa, pero tenía una zona difícil de auditar. Aunque el teléfono calculase localmente y enviase actualizaciones protegidas, ¿cómo podía una persona externa comprobar qué hacía realmente el servidor con ellas?
El 2 de octubre de 2026, Google Research presentó una nueva arquitectura que intenta cerrar esa brecha. El sistema combina aprendizaje federado, privacidad diferencial, entornos de ejecución confiables y registros públicos de transparencia. Ya se ha utilizado para entrenar modelos de predicción de texto en inglés y japonés de Gboard, según el artículo técnico publicado por sus investigadores.
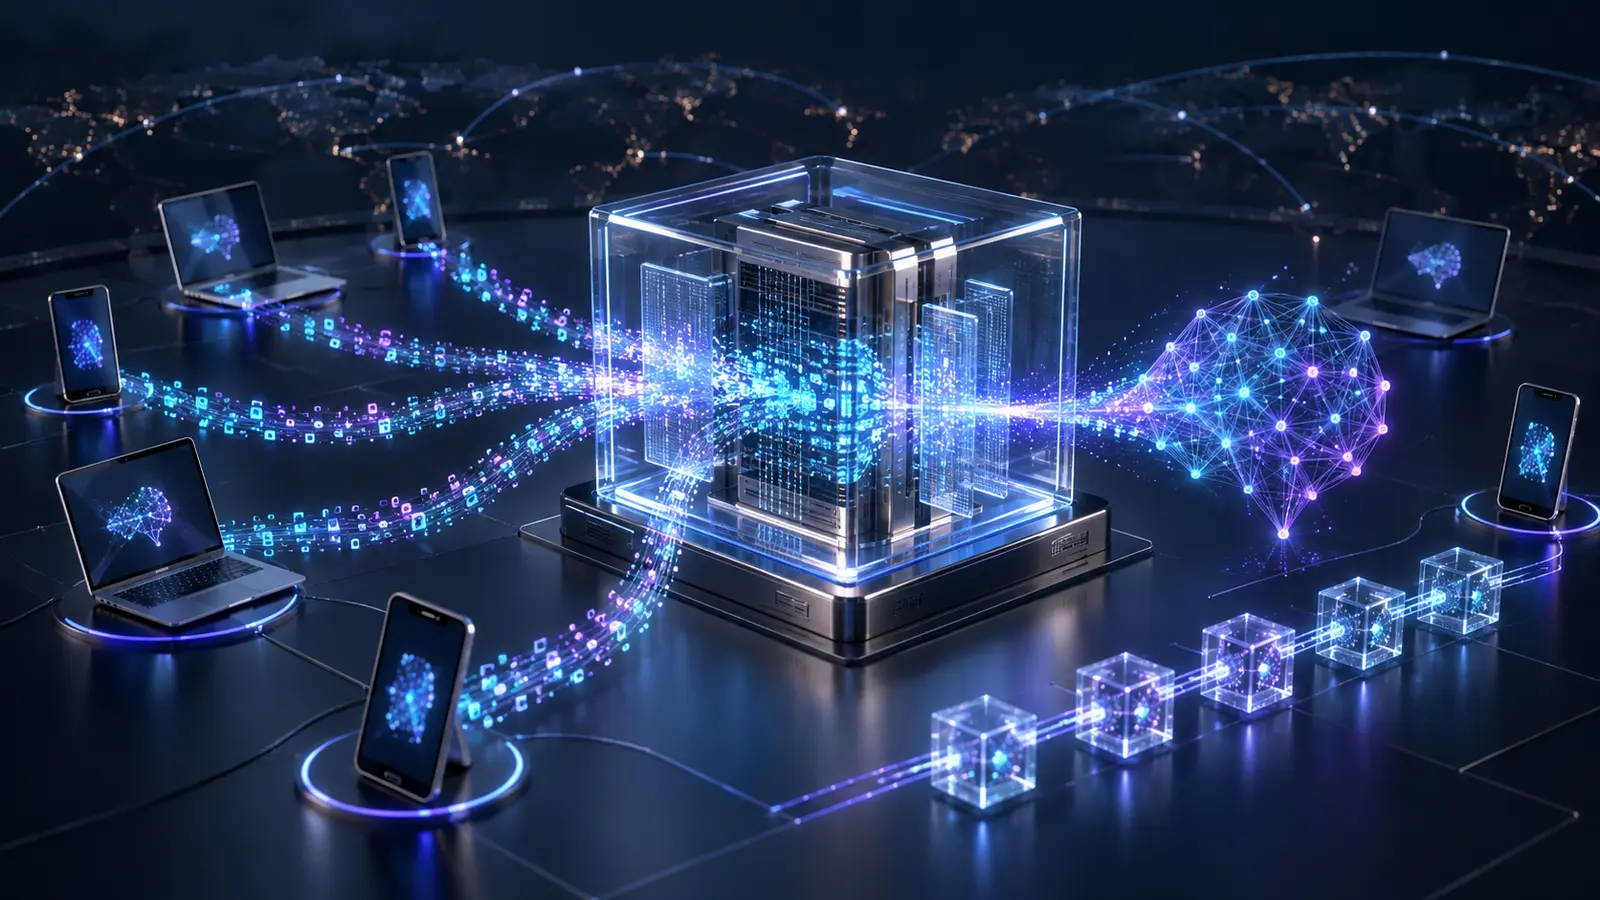
El avance es relevante porque cambia el reparto del trabajo: los dispositivos cifran y suben ejemplos de entrenamiento, mientras que una parte mucho mayor del cálculo se realiza en servidores protegidos. Esto puede acelerar el entrenamiento y ampliar la participación. Sin embargo, «verificable» no significa invulnerable, ni autoriza a concluir que cualquier dato enviado a un servidor queda automáticamente a salvo.
Qué problema intenta resolver
En el aprendizaje federado clásico, el modelo viaja hasta los dispositivos. Cada móvil calcula una actualización con sus datos locales y el servidor combina las contribuciones. La materia prima, por ejemplo lo que una persona ha escrito, no debería salir del dispositivo.
El diseño reduce la centralización de datos, pero introduce limitaciones prácticas. Los móviles tienen distinta potencia, disponibilidad y conectividad. Para participar suelen necesitar batería suficiente, conexión wifi y un periodo sin uso. Formar grupos sincronizados es complicado, algunos dispositivos reciben la tarea pero no la terminan y otros nunca son seleccionados.
También hay una cuestión de confianza. La agregación segura puede impedir que el servidor lea una actualización individual, y la privacidad diferencial limita lo que puede inferirse de los resultados. Aun así, en los sistemas anteriores no era sencillo para un auditor comprobar el código ejecutado en el servidor o verificar que el ruido estadístico se había añadido exactamente como se afirmaba.
💡 Tip técnico: «los datos no salen del dispositivo» y «el servidor no puede aprender información individual» son garantías distintas. Antes de evaluar un sistema, identifica qué se envía, quién puede descifrarlo, qué resultados se liberan y qué amenaza cubre cada control.
La nueva arquitectura, paso a paso
La propuesta sustituye buena parte del cálculo local por un proceso en dos fases. Primero, el dispositivo prepara ejemplos, los cifra y los vincula criptográficamente a una política de acceso. Después, el entrenamiento se ejecuta en servidores dentro de Trusted Execution Environments o TEE, que podemos traducir como entornos de ejecución confiables.
Un TEE es una zona aislada del procesador diseñada para proteger la confidencialidad y la integridad del código y de los datos mientras se están utilizando. Puede generar una atestación remota: una prueba firmada que permite comprobar qué software está ejecutando. El sistema descrito emplea tecnologías como AMD SEV-SNP e Intel TDX.
1. Política antes que datos
Antes de subir nada, el dispositivo conoce la lista de cargas de trabajo autorizadas. Esa política incluye el programa de Python que dirigirá el entrenamiento y las huellas de los binarios que lo ejecutarán. La información se cifra de manera que solo un TEE cuya atestación coincida con la política pueda obtener la clave.
2. Un gestor de claves también protegido
Las claves son administradas por un KMS formado por un clúster de TEE. Este servicio verifica las atestaciones, aplica la política y conserva estado protegido contra retrocesos. No basta con acceder a la infraestructura: el programa que solicita descifrar datos debe demostrar que es uno de los autorizados.
3. Cálculo distribuido dentro de TEE
Un nodo raíz ejecuta el programa y reparte tareas paralelizables entre nodos trabajadores, también protegidos. La coordinación utiliza Federated Language, un proyecto abierto derivado de la experiencia de TensorFlow Federated. Los canales entre nodos se cifran y el nodo raíz comprueba la atestación de los trabajadores antes de delegarles información.
4. Solo salen resultados limitados
El operador no ve los ejemplos en claro. El programa puede liberar métricas y pesos del modelo una vez aplicadas las reglas de anonimización y privacidad diferencial. El estado de recuperación se cifra para que un fallo no obligue a repetir resultados ya revelados, lo que podría gastar dos veces el presupuesto de privacidad.
💡 Tip técnico: cifrar datos en tránsito y en reposo no protege por sí solo el momento del procesamiento. Si una arquitectura presume de computación confidencial, pide evidencia sobre atestación remota, gestión de claves, control de versiones, recuperación ante fallos y protección frente a repeticiones.
Por qué el registro público importa
La confianza no descansa únicamente en el fabricante del servidor. Las políticas de acceso se publican en Rekor, el registro de transparencia del proyecto Sigstore. Esto permite que terceros observen qué cargas de trabajo podrían acceder a los datos. Los componentes principales están disponibles en el repositorio abierto Confidential Federated Compute y pueden construirse de forma reproducible.
La combinación de código inspeccionable, compilaciones reproducibles, huellas de binarios y atestación crea una cadena de confianza. Un auditor puede relacionar una política publicada con un programa concreto y, a su vez, con el binario que un TEE declara estar ejecutando.
Esto no equivale a una prueba matemática de todo el sistema. Google habla de avanzar hacia garantías verificables y reconoce como trabajo futuro las pruebas completas de corrección del software y de los algoritmos de privacidad diferencial. El repositorio también indica que el proyecto no es un producto de Google con soporte oficial.
💡 Tip técnico: un registro de transparencia ayuda a detectar y auditar cambios, pero solo si alguien lo supervisa. En producción conviene automatizar alertas ante nuevas políticas, binarios no reconocidos o compilaciones que no reproducen la huella esperada.
Qué resultados ha medido Google
El artículo compara el sistema nuevo con la infraestructura federada anterior en modelos de Gboard. Son resultados comunicados por los autores sobre su propia implementación; todavía no constituyen una validación independiente.
En un modelo de japonés, el sistema previo incorporó 8,5 millones de dispositivos durante 3.000 rondas de entrenamiento a lo largo de 38 días. La nueva arquitectura recogió 17,8 millones de cargas cifradas en aproximadamente seis días y utilizó todas ellas en el entrenamiento posterior. El trabajo local era menor, de modo que se produjeron menos interrupciones.
Para un modelo de inglés, la prueba en producción asignó 3,5 millones de dispositivos a cada variante. La mejor configuración basada en TEE consumió un presupuesto de privacidad zCDP de 0,215 frente a 0,641 en el modelo de producción comparable, aproximadamente tres veces menor, y mantuvo resultados neutros en métricas como palabras por minuto y proporción de palabras modificadas. El entrenamiento se completó en tres semanas, frente a dos meses en el sistema anterior.
Estas cifras no significan que la nueva arquitectura sea siempre seis veces más rápida o tres veces más privada. Dependen del modelo, el número de dispositivos, la planificación de sus contribuciones, las rondas, el tamaño de cada cohorte y el presupuesto elegido. Lo demostrable es que, en esos ensayos, reunir primero las cargas permitió optimizar mejor la participación y el ruido estadístico.
💡 Tip técnico: nunca compares sistemas de privacidad solo por una cifra de epsilon o zCDP. Comprueba la definición empleada, la unidad de protección, cuántas veces puede participar cada persona, el mecanismo de composición y si las métricas de utilidad se mantienen.
La privacidad diferencial no oculta cada dato
La privacidad diferencial establece un límite cuantificable sobre cuánto puede cambiar el resultado al incluir o excluir la contribución de una persona. Para conseguirlo se recortan contribuciones y se añade ruido. Un presupuesto menor suele representar una garantía más estricta, aunque la comparación solo es válida cuando se utiliza la misma definición y un mecanismo equivalente.
En este sistema, la protección tiene dos capas complementarias. Los TEE impiden que el operador observe los ejemplos durante el cálculo, dentro de las garantías y límites del hardware. La privacidad diferencial protege los pesos y métricas que abandonan el entorno seguro. Una capa controla quién puede procesar; la otra limita qué puede revelar el resultado.
El código autorizado sigue siendo decisivo. La interfaz permite que el programa emita resultados en claro y es responsabilidad del autor aplicar la anonimización prometida. La diferencia es que la parte relevante de ese programa queda vinculada a la política pública y puede ser inspeccionada.
Los límites que no conviene esconder
Se suben ejemplos cifrados, no solo gradientes
El nuevo diseño reduce el cálculo en el móvil, pero cambia la frontera: el dispositivo sube datos de entrenamiento cifrados al servidor. El operador no debería poder leerlos, pero la seguridad depende de la implementación del TEE, del KMS, de las políticas y de la cadena de atestación. No es el mismo modelo de riesgo que mantener los ejemplos exclusivamente en el terminal.
Los TEE tienen superficies de ataque
Los autores citan limitaciones de la generación actual, incluidas posibles observaciones por canales laterales. Un TEE reduce la confianza depositada en el operador y en parte del software de infraestructura, pero no elimina fallos de hardware, microarquitectura, firmware o código autorizado.
No todo lo cargado dinámicamente es público
El sistema admite parámetros y transformaciones propietarias incorporadas en ejecución. Google sostiene que la lógica relevante para la privacidad debe permanecer en el programa público y que los auditores pueden analizar cómo se usan esas entradas. Aun así, la capacidad de cargar información dinámica amplía lo que debe incluir el modelo de amenazas.
La escala todavía es limitada
Los experimentos descritos llegan a modelos de hasta diez millones de parámetros y utilizaron tan solo catorce máquinas en algunos entrenamientos. Para modelos mayores harían falta TEE con aceleradores, además de resolver cuellos de botella de comunicación. No es una receta inmediata para entrenar un gran modelo generativo con datos privados de millones de móviles.
💡 Tip técnico: incorpora los TEE a una defensa por capas. Mantén minimización de datos, periodos de retención, privacidad diferencial, separación de funciones, rotación de claves, auditoría de políticas y respuesta a vulnerabilidades del hardware.
Qué puede aprender una empresa de este diseño
La mayoría de las empresas no necesita construir una infraestructura federada global. Sin embargo, el enfoque ofrece criterios útiles para cualquier proyecto que procese datos sensibles con IA:
- Definir la política antes de recopilar: concretar qué programas podrán usar la información y durante cuánto tiempo.
- Separar el operador del acceso al dato: administrar una plataforma no debería implicar poder leer todos sus contenidos.
- Hacer verificables las promesas: conservar código, configuración, versiones y evidencias de ejecución, en lugar de depender de una declaración genérica.
- Controlar cada salida: los pesos, métricas y registros pueden filtrar información aunque el cálculo esté aislado.
- Diseñar la recuperación: reintentar un cálculo privado sin controlar estados y resultados anteriores puede ampliar la exposición.
Estas preguntas enlazan con la observabilidad que tratamos en nuestro artículo sobre agentes de IA y con la revisión de permisos, credenciales y datos explicada en la guía para aplicaciones creadas con IA. La tecnología cambia, pero el principio sigue siendo el mismo: una garantía técnica debe poder comprobarse en el sistema real.
Fuentes
- Google Research. Toward provably private learning from federated data, 2 de octubre de 2026.
- Daly, K. et al. Toward provably private learning from federated data, arXiv:2609.31494, versión 4 del 30 de septiembre de 2026.
- Google Parfait. Repositorio de Confidential Federated Compute, componentes abiertos para cálculo federado verificable en TEE.
- Google Parfait. Repositorio de Federated Language, infraestructura para expresar cálculos federados.
Deja una respuesta