Un agente de inteligencia artificial puede terminar una tarea sin devolver ningún error y, aun así, haber hecho algo que no debía. Quizá consultó demasiados registros, encadenó herramientas de una forma inesperada o repitió una acción hasta disparar el consumo. Para la monitorización tradicional, la sesión puede parecer un éxito: respondió, no hubo un error 500 y el proceso acabó.
El 16 de septiembre de 2026, Google presentó Agent Anomaly Detection, una capa de auditoría para agentes desplegados en Gemini Enterprise Agent Platform. La propuesta analiza trazas, llamadas a herramientas y el recorrido completo de una sesión con el objetivo de identificar comportamientos fuera de los límites previstos.
La novedad es interesante más allá del producto concreto porque señala un cambio de enfoque: cuando el software empieza a decidir qué herramienta utilizar y en qué orden, observar solo disponibilidad, latencia y errores deja de ser suficiente. También hay que poder reconstruir lo que hizo y valorar si ese comportamiento tenía sentido.
Eso no significa que una segunda IA convierta automáticamente un agente en seguro. La función está en vista previa privada, dentro de una plataforma específica y con condiciones de acceso. Sirve, eso sí, como buen punto de partida para entender qué es la detección de anomalías en agentes de IA, qué señales utiliza y dónde están sus límites.
De vigilar si funciona a vigilar cómo actúa
En una aplicación convencional, muchas operaciones importantes están definidas de antemano. Un formulario valida unos campos, ejecuta una función y guarda un registro. Podemos comprobar el código, probar rutas conocidas y alertar si el servidor responde mal.
Un agente añade una capa de decisión en tiempo de ejecución. Recibe un objetivo, interpreta el contexto, elige entre varias herramientas y utiliza sus resultados para decidir el siguiente paso. Dos solicitudes parecidas pueden producir recorridos distintos sin que exista un fallo técnico.
Pensemos en un ejemplo ficticio: un agente interno ayuda a tramitar devoluciones. Puede consultar un pedido, comprobar la política aplicable, preparar una propuesta y pedir aprobación. La respuesta final puede ser correcta, pero durante la sesión el agente podría haber consultado pedidos ajenos, solicitado más datos de los necesarios o repetido varias veces una operación.
El estado «completado» no describe ese comportamiento. Hace falta observar la secuencia: qué datos recibió, qué herramientas eligió, con qué parámetros, qué respuestas obtuvo y cómo llegó a su decisión.
Tip técnico: separa al menos tres métricas: salud técnica, calidad del resultado y comportamiento. Un agente puede tener buena disponibilidad, producir una respuesta plausible y, al mismo tiempo, utilizar una herramienta fuera del recorrido autorizado.
Qué es una traza y por qué importa en un agente
Una traza representa el camino de una solicitud a través de una aplicación. La documentación de OpenTelemetry explica que se compone de unidades de trabajo llamadas spans, enlazadas mediante identificadores y relaciones de jerarquía. Cada una puede registrar tiempos, atributos, eventos y estado.
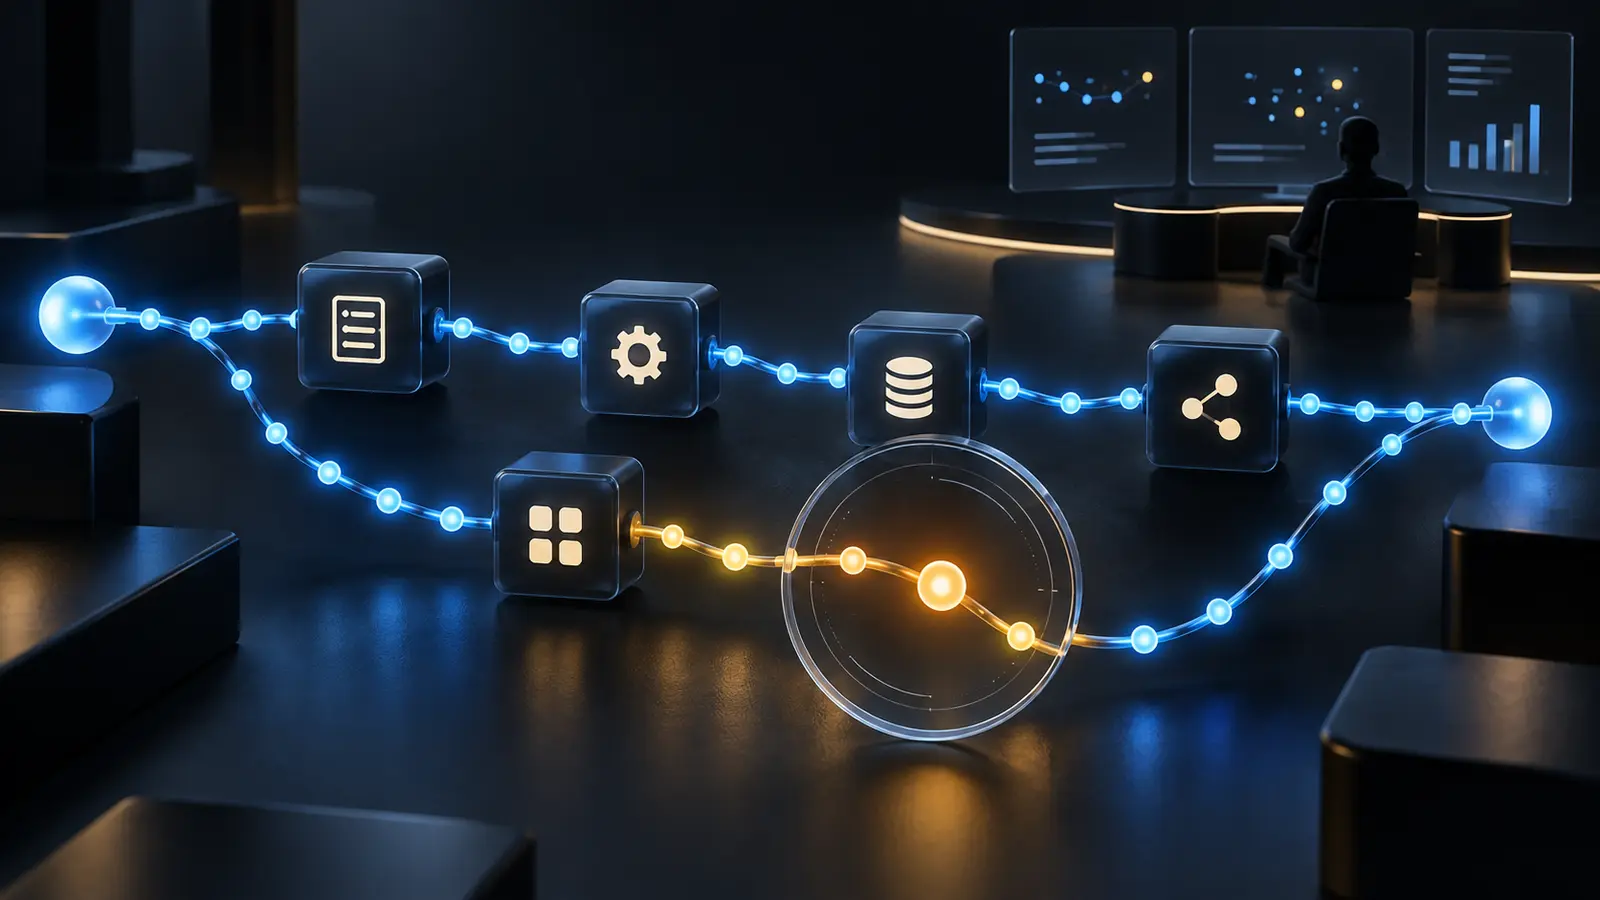
En un agente, una traza útil puede mostrar la recepción de la petición, la recuperación de contexto, la decisión de llamar a una herramienta, sus parámetros, la respuesta y la acción posterior. Así se puede pasar de «algo raro ocurrió» a una reconstrucción verificable de la sesión.
Pero instrumentar no consiste en guardar todo sin criterio. Las entradas, salidas y parámetros pueden contener datos personales, secretos, contratos o información comercial. La observabilidad necesita una política de minimización, acceso, retención y borrado. Registrar una contraseña para investigar después un incidente crea otro problema más serio.
Tip técnico: registra identificadores de sesión, herramienta, resultado, duración, decisión y versión de la configuración. Enmascara credenciales y limita el contenido sensible. Comprueba además que el filtrado se realiza antes de exportar la telemetría, no solo en la pantalla desde la que se consulta.
Cómo funciona la propuesta de Google
Según el anuncio y la documentación técnica de Google Cloud, el análisis es asíncrono: procesa registros y trazas fuera del recorrido de la solicitud. Google afirma que, por ese diseño, no añade latencia a la ejecución en vivo. La contrapartida es importante: una detección posterior no impide por sí sola la primera acción.
Primera capa: localizar sesiones atípicas
Una pasada ligera busca desviaciones estadísticas en el conjunto de tráfico. Podrían ser demasiadas llamadas, una combinación poco frecuente de herramientas o un consumo que se aleja del patrón habitual. Su función es reducir el volumen que pasa al análisis más costoso.
Segunda capa: razonar sobre el contexto
Las sesiones señaladas se examinan con una capa basada en un modelo de lenguaje. No se limita a contar llamadas: intenta distinguir una operación legítima pero poco frecuente de una conducta incompatible con el propósito del agente.
Este paso aporta contexto, pero también introduce incertidumbre. Un modelo que clasifica anomalías puede producir falsos positivos y falsos negativos. Sus hallazgos son señales para investigar o automatizar bajo condiciones cuidadosamente definidas, no hechos infalibles.
Tercera capa: reconstruir la actividad
Cuando hace falta más detalle, el sistema reconstruye las llamadas individuales para explicar qué ocurrió. Los hallazgos incluyen gravedad, explicación y acciones recomendadas, y pueden aparecer en Security Command Center. Google indica que también se exponen mediante API.
La documentación califica el producto como Pre-GA y advierte de que estas ofertas se proporcionan tal cual y pueden tener soporte limitado. El acceso requiere usuarios aprobados. Entre los requisitos actuales figuran agentes desplegados en Agent Runtime, ADK para Python 1.2 o posterior, buckets de registros y observabilidad en la multirregión de Estados Unidos, trazas activas y telemetría sin procesar que capture entradas y salidas. Son límites técnicos y de gobierno del dato relevantes antes de interpretar la novedad como una función madura y general.
Tip técnico: trata cada detector como un componente que también debe evaluarse. Crea un conjunto de sesiones normales, sospechosas y claramente prohibidas; mide qué detecta, qué confunde y cuánto tarda en avisar. Repite la prueba cuando cambien el agente, sus herramientas o el detector.
Cuatro familias de riesgo que ya no parecen ciencia ficción
Google relaciona sus detectores iniciales con categorías del OWASP Top 10 for Agentic Applications 2026, un marco revisado por especialistas para sistemas que planifican, actúan y toman decisiones. Conviene entenderlas con ejemplos sencillos.
Uso indebido de herramientas
El agente utiliza una herramienta válida de forma impropia: consulta un volumen desproporcionado, altera parámetros o encadena una lectura de contenido no confiable con una acción sensible. La herramienta puede estar funcionando exactamente como fue programada.
Abuso de identidad y privilegios
El agente actúa con permisos que no corresponden al usuario o al caso. Puede ocurrir por delegaciones confusas, credenciales compartidas o ausencia de comprobaciones al cambiar de una herramienta a otra. Saber quién inició la sesión no basta; cada acción sensible debe conservar el contexto de autorización.
Fallos en cascada
Una salida incorrecta alimenta el siguiente paso y amplifica el problema. También entran aquí bucles, reintentos crecientes o varios agentes que se confirman mutuamente sin una fuente independiente. Un límite de pasos y presupuesto puede frenar la escalada aunque todavía no se conozca la causa.
Agentes que se desvían de su función
El sistema abandona su cometido, evita una restricción o persigue un objetivo diferente del solicitado. No hay que imaginar voluntad propia: basta con una instrucción ambigua, contenido adversarial, memoria contaminada o una combinación no prevista de herramientas.
Tip técnico: escribe una matriz sencilla de agente, herramienta y operación permitida. Añade condiciones: solo lectura, importe máximo, campos autorizados, horario o aprobación. Implementa las restricciones en la capa de herramientas y permisos; no las dejes únicamente en el prompt.
Lo que la detección de anomalías no sustituye
La auditoría de comportamiento es una defensa adicional, no el control principal de acceso. Si un agente que solo resume incidencias puede borrar registros, detectar el borrado después llega demasiado tarde. El privilegio mínimo reduce el daño posible antes de que aparezca una anomalía.
Tampoco sustituye las validaciones deterministas. Límites de importe, esquemas de datos, listas de operaciones permitidas, idempotencia y aprobaciones humanas deben aplicarse en código o en la infraestructura. La IA puede ayudar a decidir si una secuencia resulta extraña, pero no debería reinterpretar una regla inequívoca para saltársela.
La supervisión humana sigue siendo necesaria en acciones difíciles de revertir. El AI Risk Management Framework de NIST plantea la gestión del riesgo como parte del diseño, desarrollo, uso y evaluación de los sistemas de IA. Un panel de anomalías es una pieza de ese proceso, no el proceso completo.
Y no todo agente necesita el mismo nivel de control. Un asistente que propone etiquetas para documentos no presenta el mismo impacto que otro capaz de emitir reembolsos o modificar un ERP. El esfuerzo debe guardar relación con los datos, permisos, reversibilidad y consecuencias.
Tip técnico: clasifica las herramientas por efecto: lectura, propuesta, escritura reversible y acción difícil de revertir. Exige controles crecientes en cada nivel. Si una acción no puede deshacerse con seguridad, añade aprobación previa y no confíes solo en una alerta posterior.
Qué conviene observar en la práctica
No existe una lista universal, pero hay señales que ayudan a empezar:
- número y orden de llamadas a herramientas por tipo de tarea;
- cambios bruscos de volumen, duración, tokens o coste;
- accesos a recursos fuera del ámbito del usuario;
- reintentos, bucles y acciones repetidas sobre el mismo objeto;
- cambios de privilegio o identidad durante la sesión;
- acciones sensibles sin aprobación o sin justificación registrada;
- diferencia entre el objetivo declarado y el resultado operativo.
Una frecuencia alta no es necesariamente maliciosa: un cierre mensual puede multiplicar las consultas legítimas. Y una sola llamada puede ser grave si utiliza la herramienta equivocada. Por eso conviene combinar umbrales, reglas de negocio y análisis contextual.
Las alertas también necesitan un procedimiento. ¿Quién las recibe? ¿Qué evidencia puede consultar? ¿Puede detener el agente, revocar una credencial o bloquear una herramienta? ¿Cómo se recuperan los casos pendientes? Una alerta sin responsable acaba convertida en ruido.
Tip técnico: define niveles de respuesta antes del incidente. Por ejemplo: observar; pedir revisión; suspender una herramienta; detener la sesión; revocar temporalmente un acceso. Para cada nivel, documenta responsable, plazo, evidencia mínima y forma de reanudar sin repetir acciones.
Una prueba razonable antes de dar autonomía
Empieza en un entorno sin efectos reales. Incluye solicitudes normales, datos incompletos, instrucciones contradictorias, contenido externo que intenta alterar el objetivo y fallos de las herramientas. Comprueba el resultado y el recorrido.
Después limita el despliegue: pocos usuarios, permisos de lectura o acciones que requieran confirmación. Conserva una versión de la configuración y relaciona cada sesión con el modelo, herramientas y políticas activos. Si algo cambia, podrás comparar.
Mide tanto el agente como la supervisión. Una detección que genera cientos de avisos irrelevantes puede ocultar el incidente importante. Otra demasiado conservadora puede no detectar una desviación lenta. Revisa falsos positivos, falsos negativos, tiempo de detección y capacidad real de respuesta.
Este enfoque conecta con una idea que ya tratamos al hablar de mantenimiento de automatizaciones con IA: que un proceso complete sus ejecuciones no demuestra que siga produciendo el resultado correcto. La observabilidad debe llegar hasta el efecto en el negocio.
Observar decisiones, no solo errores
La novedad de Google muestra hacia dónde se mueve la seguridad de los agentes: reconstruir sesiones y analizar el uso de herramientas, no limitarse al código o al perímetro. Es un avance relevante, pero todavía acotado a una vista previa privada y a la infraestructura de un proveedor.
La enseñanza más general sí puede aplicarse ya. Antes de ampliar la autonomía de un agente, define qué puede hacer, instrumenta su recorrido, protege la telemetría, limita los efectos y prepara una respuesta. Detectar que algo se ha desviado es valioso; impedir que una desviación pueda causar un daño irreversible lo es más.
Fuentes
Fuentes oficiales consultadas el 19 de septiembre de 2026. Las capacidades y requisitos descritos corresponden a la documentación disponible en esa fecha.
Deja una respuesta