El 4 de septiembre de 2026, GitHub presentó Project HydraFusion, una vista previa de investigación para GitHub Copilot CLI. La novedad no consiste en otro gran modelo que haya aprendido a programar mejor. Consiste en elegir, durante una tarea, cómo combinar modelos y comprobaciones para obtener una respuesta útil sin gastar siempre la opción más potente.
En unas solicitudes basta con un modelo. En otras, uno rápido puede proponer una solución y un control decide si es necesario escalar. Y hay tareas en las que un segundo modelo critica el borrador antes de una revisión. Es una forma de convertir la selección de IA en un flujo de trabajo, no solo en un menú desplegable.
GitHub comunica buenos resultados en pruebas controladas, pero también reconoce que todavía debe comprobar cómo se traducen a sesiones reales y prolongadas. La pregunta interesante no es si HydraFusion ha «ganado» una comparativa, sino qué enseña sobre el siguiente paso de los agentes de programación: medir el trabajo completo, controlar el estado del repositorio y añadir comprobaciones donde aportan valor.
De elegir un modelo a elegir una estrategia
Hasta ahora, una decisión frecuente era escoger el modelo apropiado antes de empezar. Uno pequeño para una modificación sencilla; otro más capaz para explorar dependencias, depurar o diseñar una solución. GitHub ya tiene una función de selección automática de modelo que evalúa la tarea y la disponibilidad. HydraFusion añade otra capa: selecciona también el patrón de ejecución.
La diferencia puede parecer sutil, pero cambia lo que sucede después de la primera respuesta. Si el sistema detecta que la propuesta no supera un control de aceptación, puede elevar el trabajo a otro modelo. Si espera que una crítica independiente sea más útil, puede revisar y corregir una vez. No trata todos los encargos como si fueran iguales.
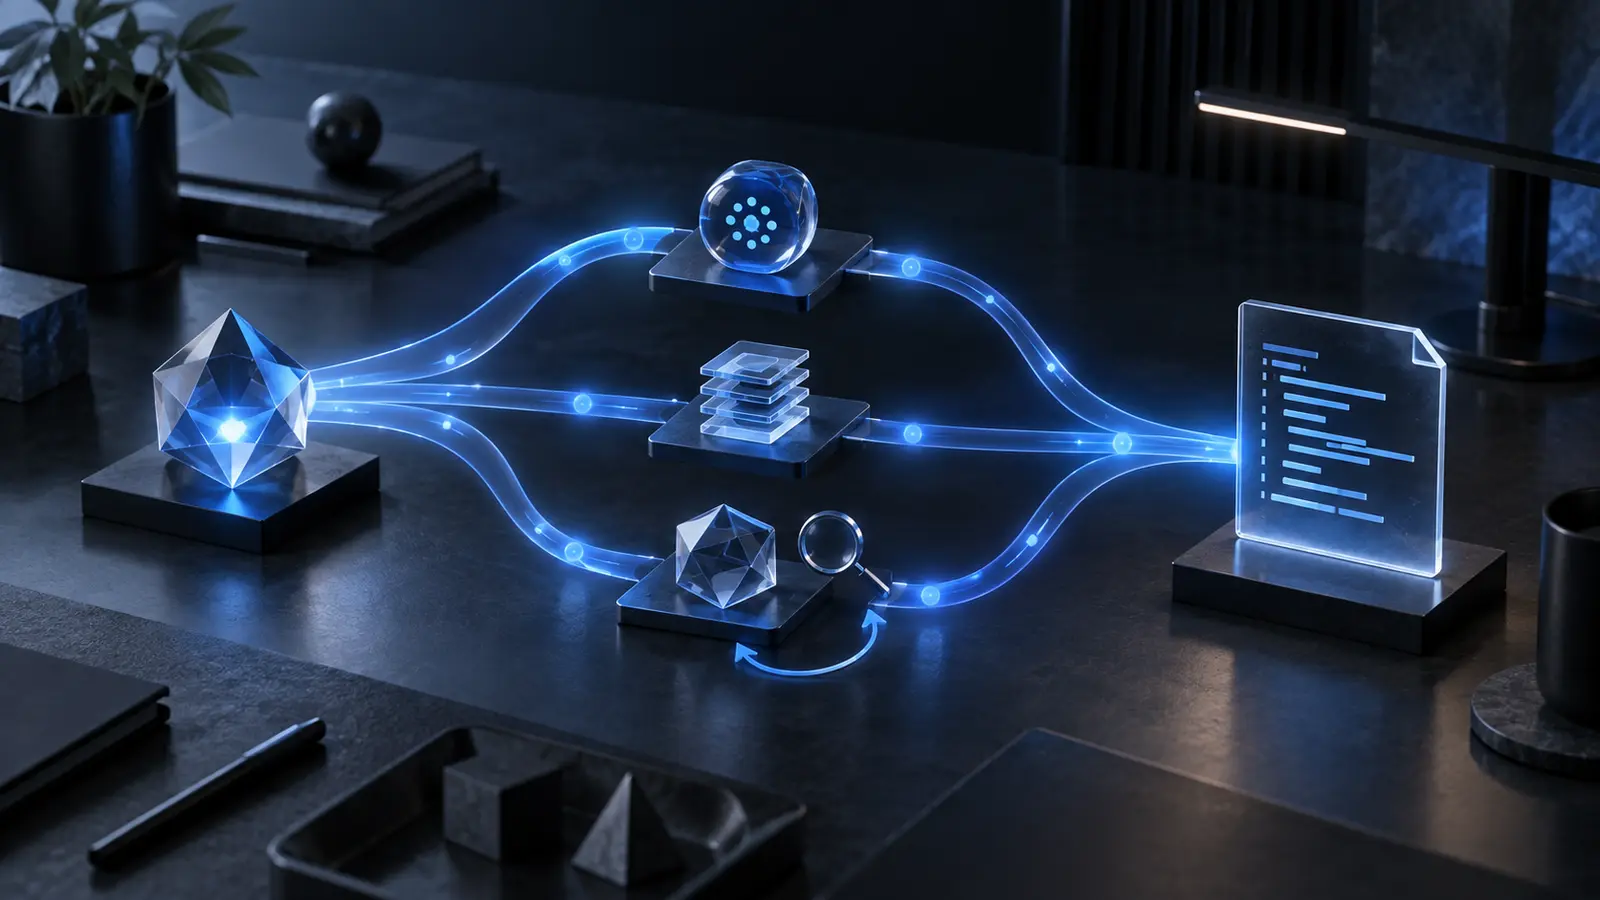
Esto se conoce como orquestación multimodelo. «Multi» no significa necesariamente que todos los modelos se ejecuten en paralelo ni que siempre se llame a varios. La idea es escoger una secuencia apropiada para la tarea. GitHub dice que utiliza señales sobre razonamiento, generación de código, depuración y uso de herramientas para seleccionar el patrón más eficiente que alcance un nivel de calidad.
Tip técnico: si comparas soluciones de programación asistida, registra la tarea completa: llamadas iniciales, reintentos, revisiones, tiempo hasta un cambio verificable y trabajo humano posterior. El precio de una sola respuesta no representa el coste del flujo.
Las tres rutas actuales de HydraFusion
Según la descripción de GitHub, la vista previa selecciona actualmente entre tres patrones. Son una explicación del diseño anunciado, no una receta que debamos aplicar ciegamente a cualquier proyecto.
Ruta única: un modelo resuelve
El sistema elige un modelo y deja que responda directamente. Puede ser lo apropiado para una modificación acotada en la que introducir una segunda revisión solo añade espera y consumo. Pensemos en actualizar un mensaje de error con pruebas claras: hay poco que ganar haciendo que tres modelos discutan el cambio.
Esto no significa que el resultado se dé por bueno sin verificación. «Ruta única» describe las llamadas a modelos, no la eliminación de tests, revisión de código o aceptación humana.
Cascada: primer intento y posible escalada
Un modelo eficiente prepara la solución; después, una puerta de calidad decide si se acepta o si hace falta recurrir a un modelo más capaz. El ahorro depende de que una fracción suficiente de encargos se resuelva en el primer paso. Si casi todos escalan, la primera llamada se convierte en un coste añadido.
Por ejemplo, una tarea que pide corregir una importación puede parecer pequeña, pero un primer análisis descubre que el cambio afecta a varios módulos y a un contrato de API. Ahí una escalada podría ser razonable. La clave es cómo se juzga la suficiencia, no la promesa de que «el modelo pequeño hará casi todo».
Crítica: propuesta, lectura independiente y revisión
Un modelo redacta una solución y otro, de una familia diferente, actúa como crítico. Ese crítico opera en un contexto aislado y sin herramientas que modifiquen el repositorio; después, el modelo redactor revisa la propuesta una vez. GitHub lo presenta como una crítica de solo lectura, no como dos agentes editando el mismo archivo simultáneamente.
Puede resultar útil cuando hay riesgos de interpretación: una refactorización que modifica el comportamiento público, un cambio en controles de permisos o una consulta que admite varias soluciones razonables. Una segunda perspectiva no sustituye una prueba de integración ni una revisión de seguridad, pero puede detectar supuestos que la primera pasada ignoró.
Tip técnico: separa el papel de quien modifica del de quien critica. Da al revisor criterios verificables (contrato, pruebas, permisos, regresiones) y evita que una crítica genérica de estilo sea el único filtro de aceptación.
Por qué importa el estado del repositorio
En un chat, varias respuestas pueden coexistir sin afectar a nada. En un agente de programación, cada paso puede leer archivos, ejecutar comandos y preparar cambios. Una estrategia multimodelo necesita reglas para impedir que las etapas intermedias dejen el proyecto en un estado incoherente.
GitHub enumera cinco principios de implementación: contabilizar todas las etapas; limitar tiempos y cancelaciones; aislar la crítica; no aplicar un parche si el flujo se cancela o falla la validación; y comprobar las rutas, modelos y alternativas antes de ejecutar. En las etapas que resuelven la tarea se utiliza el espacio de trabajo compartido y el ciclo normal de permisos; la crítica no puede modificarlo.
Esto apunta a un problema real. Si un agente modifica tres ficheros y otro revisa una versión anterior, la crítica puede estar hablando de una realidad que ya no existe. Si un fallo interrumpe la operación a medias, un archivo compilable no garantiza que todo el conjunto sea correcto. La solución no consiste en sumar modelos, sino en definir qué puede hacer cada etapa y cuándo una modificación se considera aceptada.
Tip técnico: para una prueba propia, parte de una rama limpia, conserva el commit inicial, captura el diff final y ejecuta una batería repetible de pruebas. Si el proceso falla o se cancela, verifica explícitamente que no se han incorporado cambios parciales.
Qué dicen realmente las cifras
GitHub evaluó políticas fijas en tres benchmarks de programación con agentes, usando las mismas tareas, herramientas, límites, condiciones de corrección y supuestos de precios para cada comparación. Reporta calidad verificada (proporción de tareas confirmadas como correctas) y coste estimado del flujo completo, incluyendo borradores, críticas, revisiones, escaladas, reintentos y alternativas.
Frente al Claude Opus 5 evaluado, GitHub informa de lo siguiente para la configuración de HydraFusion mejor ajustada:
- TerminalBench 2.1: 4,9 puntos porcentuales más de calidad verificada y un 67 % menos de coste estimado.
- DeepSWE: 1,5 puntos porcentuales menos de calidad y un 36 % menos de coste estimado.
- CheckpointBench: 0,1 puntos porcentuales menos de calidad y un 65 % menos de coste estimado.
No conviene resumir eso como «un 67 % más barato e igual de bueno siempre». Son comparaciones relativas a una configuración concreta de referencia en pruebas sin conexión; uno de los tres benchmarks muestra una calidad inferior. Tampoco ofrecen una cifra universal de éxito, un precio por proyecto ni una garantía para una aplicación de empresa.
CheckpointBench es una prueba interna, curada por GitHub a partir de sesiones de Copilot ancladas a repositorios públicos y commits inmutables. Eso favorece la repetibilidad, pero no la convierte en una auditoría externa independiente. GitHub explica además que ajustó políticas repetidamente sobre conjuntos de evaluación y que la vista previa servirá para contrastar los resultados con cargas reales.
La medida de coste incluye las llamadas a modelos; no equivale al coste total de desarrollar y mantener software. Revisar el cambio, integrarlo, desplegarlo y corregir posibles incidencias sigue siendo trabajo. Y la latencia, aunque forma parte del objetivo de optimización, no queda resumida en esa tabla comparativa.
Tip técnico: al leer benchmarks, pregunta siempre qué tareas se incluyeron, cuál fue el modelo de referencia, cómo se contabilizaron los fallos, si el resultado es interno o reproducible por terceros y si el coste es observado o estimado.
Una vista previa, no una solución universal
GitHub ofrece HydraFusion como research preview en Copilot CLI mediante el modo experimental. Según su anuncio, está disponible en todos los planes de Copilot a través de /experimental y el consumo se basa en los tokens de los modelos utilizados, a sus tarifas habituales. En una organización, la política de acceso a Copilot CLI debe permitir su uso.
GitHub recomienda comenzar con encargos de programación sustanciales pero acotados, formulados en un solo prompt. La mejora de sesiones largas y de varios turnos aún forma parte del trabajo pendiente. También advierte de que resultados, modelos, rutas, disponibilidad, nombre y comportamiento pueden cambiar durante la vista previa.
Hay además una cuestión de confianza en el entorno. Copilot CLI puede intentar leer, modificar o ejecutar archivos dentro de la carpeta de trabajo y solicita confirmación para ciertas herramientas. Activar un patrón con crítica aislada no elimina la necesidad de controlar permisos, datos sensibles o alcance de los comandos.
Tip técnico: prueba una función experimental con un repositorio de ensayo o una rama no crítica y datos no sensibles. Revisa qué modelos y proveedores pueden intervenir según tu plan y las políticas de la organización antes de usarla con código confidencial.
Cómo probar la idea sin caer en la trampa del titular
No hace falta adoptar HydraFusion para aplicar la lección principal. Un equipo puede diseñar una evaluación pequeña que compare tres alternativas: un único modelo para cada tarea, un modelo con revisión independiente y una estrategia de escalada. El objetivo no es demostrar que la orquestación «gana», sino averiguar para qué tareas aporta algo.
Elige problemas representativos: una corrección trivial, una modificación entre varios módulos, un fallo difícil de reproducir y un cambio que afecta a permisos o datos. Define antes qué se considera correcto: tests, comportamiento observado, mantenibilidad y límites de seguridad. Ejecuta cada alternativa con el mismo estado inicial y condiciones lo más comparables posible.
Mide resultados por tarea, no solo promedios agregados. Una estrategia más barata puede ser buena para tareas rutinarias y mala para una refactorización compleja. Cuenta también el tiempo de revisión humana y el esfuerzo para reparar una solución fallida. Si hay pocos ejemplos, presenta los números como observaciones locales, no como una estimación estadística generalizable.
La búsqueda de eficiencia tiene otra cara: la puerta de calidad. Un filtro excesivamente permisivo aceptará cambios incorrectos; uno demasiado estricto escalará todo y consumirá tiempo sin beneficio. Ajustarlo exige observar falsos positivos y negativos con ejemplos conocidos.
Tip técnico: conserva para cada ejecución el prompt, commit inicial, modelo o ruta usados, diff final, pruebas, resultado de revisión, duración y consumo. Ese registro permite investigar por qué una solución aparentemente económica acabó requiriendo mucho trabajo posterior.
Qué nos dice sobre el futuro de los agentes de programación
La evolución no se limita a agrandar modelos. Un agente se parece cada vez más a un sistema que toma decisiones sobre herramientas, rutas, revisiones y límites. Lo vimos al hablar del paso de los LLM que responden a los agentes que actúan: la capacidad de actuar vuelve decisiva la forma de comprobar el resultado.
HydraFusion es un caso concreto, de un proveedor y todavía en fase experimental. Su valor informativo está en mostrar que la calidad debe medirse al nivel del proceso: qué se pidió, qué se modificó, quién o qué revisó, cuánto tardó, qué costó y si el cambio superó pruebas. Un modelo más capaz puede ayudar, pero una ejecución mal acotada sigue siendo una ejecución mal acotada.
La estrategia es parte de la inteligencia
El anuncio de GitHub del 4 de septiembre presenta tres rutas para resolver tareas de código: una respuesta directa, una posible escalada y un ciclo de crítica independiente con una revisión. Las pruebas controladas muestran compromisos interesantes entre calidad y coste estimado, con diferencias según el benchmark. Por ahora, la vista previa no demuestra cómo se comportará en todas las sesiones reales.
Para equipos técnicos, la enseñanza práctica es clara: delimitar las tareas, registrar el coste de todas las etapas, verificar el diff y las pruebas, controlar los permisos y reservar una segunda revisión para los cambios que realmente la merecen. Más modelos no implican automáticamente mejor software; mejores decisiones sobre cuándo usarlos pueden marcar la diferencia.
Si te interesa discutir cómo aplicar estas ideas a un proceso de desarrollo o mantenimiento concreto, cuéntanos qué tipo de tareas queréis automatizar, en qué entorno trabajáis y cómo verificáis hoy los cambios. Con ese contexto podremos orientar una conversación útil, sin dar por supuesto que necesitáis una herramienta experimental.
Deja una respuesta