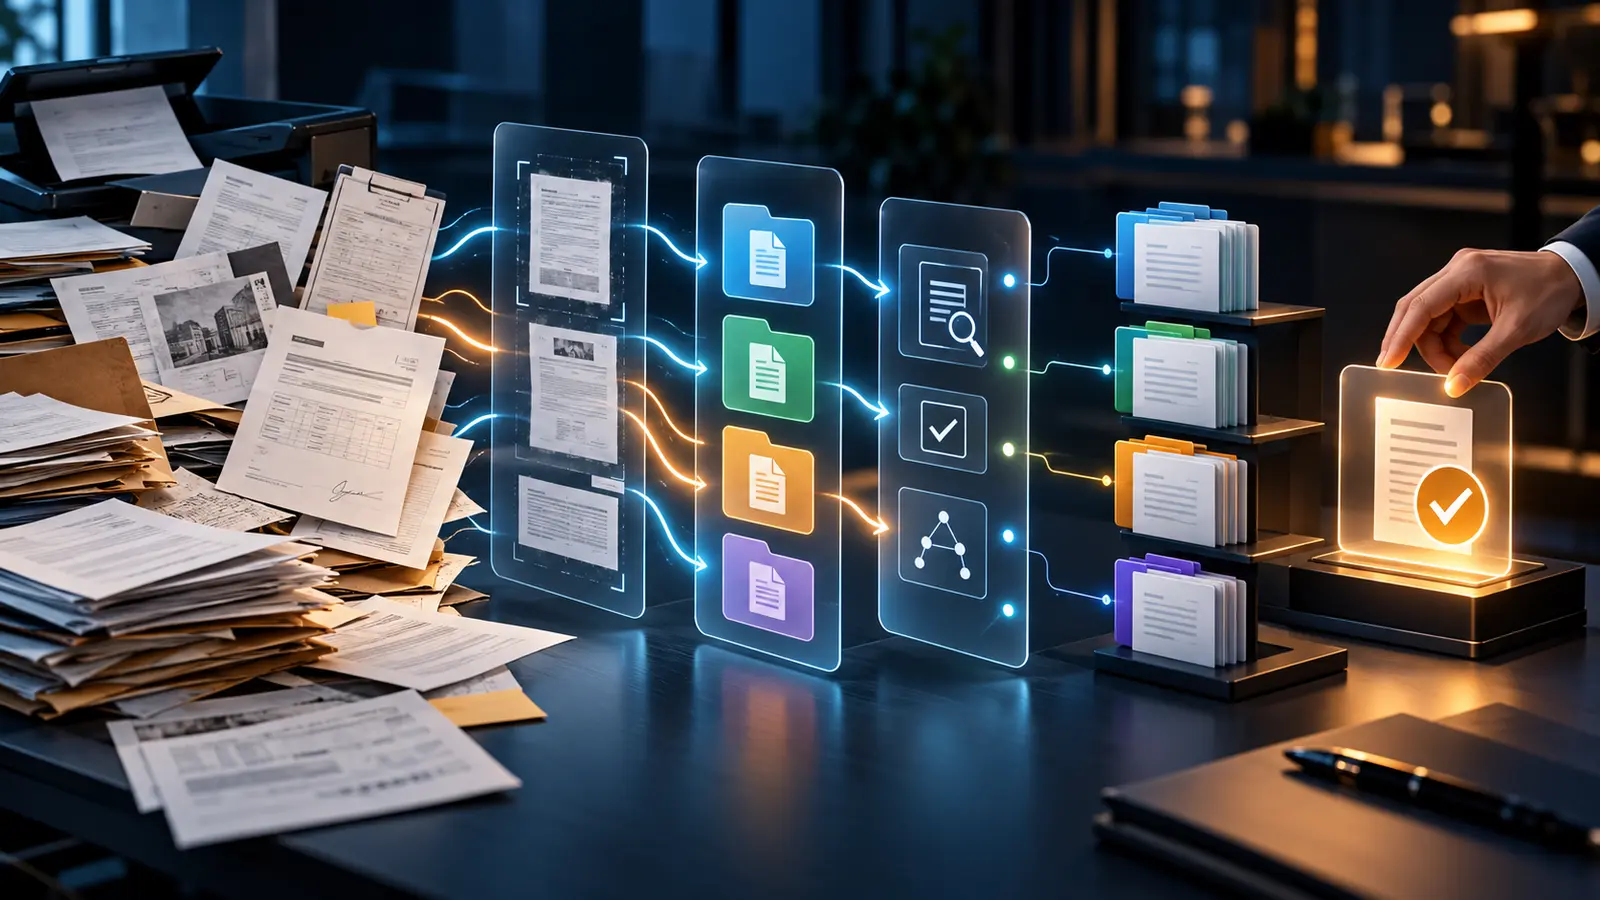
Digitalizar un documento es convertirlo en archivo. Automatizarlo es conseguir que la información llegue al lugar correcto, con controles, excepciones y una persona responsable cuando algo no encaja. Entre ambas cosas suele haber un trecho considerable.
La tecnología está avanzando deprisa. En septiembre de 2026, Microsoft publicó nuevas herramientas para integrar y probar su plataforma de comprensión de contenidos; en agosto había ampliado los SDK y las funciones de confianza y trazabilidad hasta el fragmento de origen. OpenAI, por su parte, permite forzar respuestas que respeten un esquema JSON. Son avances útiles porque facilitan pasar de un PDF desordenado a datos que un programa pueda consumir. Pero las propias documentaciones introducen dos matices importantes: una salida estructurada todavía puede contener errores y los umbrales de confianza deben validarse para cada caso.
Para una empresa, por tanto, la pregunta ya no es solo si la IA puede leer un albarán, un contrato, un parte de trabajo o una solicitud. La pregunta operativa es otra: ¿qué sucede desde que ese documento llega hasta que alguien puede trabajar con sus datos? Ahí están la clasificación, las comprobaciones, los duplicados, la revisión humana, la integración y la trazabilidad. Este artículo explica cómo diseñar ese recorrido sin convertir la IA en una caja negra ni construir un proyecto mayor de lo necesario.
Un archivo digital no es todavía un proceso
Imaginemos una empresa de mantenimiento que recibe por correo partes firmados, fotografías, presupuestos y hojas de materiales. Guardarlos en una carpeta compartida evita el papel, pero no elimina el trabajo de abrirlos, reconocer qué son, localizar el número de servicio, comprobar que aparece la firma y trasladar determinados datos a la aplicación interna.
Un OCR tradicional puede reconocer caracteres. Una capa de IA puede interpretar distribuciones distintas, clasificar documentos y extraer campos según un esquema. Aun así, ninguna de esas piezas decide por sí sola qué hacer cuando falta una referencia, aparecen dos importes incompatibles o el archivo pertenece a un asunto que no debería procesarse. Esa decisión forma parte del proceso de negocio.
La automatización documental fiable se parece menos a «preguntar a un modelo» y más a una pequeña cadena de producción: entrada controlada, identificación, extracción, validación, revisión de excepciones y entrega al destino. Si una etapa no deja evidencias, el problema reaparece cuando hay que explicar de dónde salió un dato.
Tip técnico: dibuja el recorrido actual antes de elegir tecnología. Anota canal de entrada, tipos de documento, campos que se copian, reglas que se comprueban, persona que resuelve dudas y sistema de destino. Si una decisión no puede explicarse en este mapa, tampoco será fácil automatizarla.
Las seis etapas de una automatización documental útil
1. Capturar sin perder el original
Los documentos pueden llegar por un buzón, un formulario web, una carpeta, una aplicación móvil o una API. El primer requisito es conservar el archivo original y asociarle un identificador estable. Renombrarlo con un dato extraído por la IA antes de verificarlo es una mala idea: si el dato está mal, también lo estará la pista con la que intentaremos localizar el documento.
Conviene registrar al menos la fecha de recepción, el canal, el tipo de archivo, un identificador del mensaje o transacción y, cuando tenga sentido, una huella digital del contenido. La huella no demuestra que el documento sea auténtico, pero permite comprobar si dos archivos contienen exactamente los mismos bytes y detectar reenvíos o duplicados técnicos.
2. Separar y clasificar
Un correo puede incluir una portada, dos partes y una fotografía; un PDF puede contener documentos de varias clases. Antes de extraer campos hay que decidir si se procesa el conjunto, cada archivo o cada sección. También hace falta una categoría «otro» para aquello que no encaja. Forzar cualquier entrada dentro de una lista cerrada produce clasificaciones aparentemente limpias y operativamente falsas.
Tip técnico: devuelve una clase, una puntuación de confianza y una razón de rechazo. Cuando el sistema no reconoce el documento, debe enviarlo a una cola de revisión, no escoger silenciosamente la opción más parecida.
3. Extraer con un esquema explícito
El esquema define qué datos se esperan y de qué tipo son. Por ejemplo: referencia como texto, fecha en formato normalizado, importe como número decimal y líneas como una lista. Las salidas estructuradas reducen los problemas de formato y evitan respuestas libres difíciles de integrar. La documentación de OpenAI confirma que un esquema estricto puede asegurar la forma de la respuesta, pero advierte de que el contenido aún puede contener equivocaciones y de que una entrada incompatible puede inducir valores inventados si no se contempla el caso vacío.
Por eso los campos opcionales deben admitir un valor nulo real. «No encontrado» es información válida. Completar por intuición un número de pedido o una fecha que no aparece en el documento puede ser mucho más perjudicial que detener el proceso.
Tip técnico: para cada campo define tipo, formato, obligatoriedad, evidencia de origen y comportamiento cuando falta. No uses una cadena vacía para mezclar «no aparece», «no se ha podido leer» y «no aplica»: son estados diferentes y pueden exigir acciones distintas.
4. Validar con reglas del negocio
Una extracción correcta desde el punto de vista visual puede ser inválida para la empresa. El código de cliente quizá no exista, la fecha podría estar fuera del periodo permitido o la suma de las líneas no coincidir con el total. Estas comprobaciones son más estables y explicables cuando se expresan como reglas deterministas, consultas al sistema maestro o comparaciones matemáticas.
La IA interpreta lo ambiguo; las reglas comprueban lo que ya conocemos. Mezclar ambas funciones en una única instrucción dificulta saber por qué se aceptó un documento y hace más costosa la corrección de fallos.
5. Revisar según riesgo, no todo por igual
La documentación reciente de Microsoft propone utilizar puntuaciones de confianza diferentes según la criticidad del campo y recalca que sus ejemplos de umbrales son orientativos. Esa es la idea importante: no existe un porcentaje universal que convierta cualquier salida en verdad. Un comentario interno y un IBAN no tienen el mismo impacto; tampoco una referencia usada para archivar que una fecha que activa una penalización contractual.
Los umbrales deben establecerse con documentos representativos y errores observados. Puede automatizarse el camino habitual y reservar una bandeja para los casos dudosos, incompletos o incoherentes. La revisión humana deja entonces de ser volver a teclear todo y pasa a concentrarse en excepciones concretas, con el original y el campo señalado a la vista.
Tip técnico: mide precisión por campo y por tipo de documento, no solo un promedio global. Una exactitud alta puede ocultar que el dato más crítico falla con frecuencia. Registra también falsos positivos: campos aceptados automáticamente que después resultaron incorrectos.
6. Entregar y confirmar
El proceso no termina cuando se obtiene un JSON. Falta crear o actualizar un registro, adjuntar el original, evitar duplicados y confirmar que el sistema de destino aceptó la operación. Si la API falla, hay que poder reintentar sin crear dos pedidos ni perder el estado de revisión.
Una clave de idempotencia o un identificador externo ayuda a que dos intentos representen la misma operación. También conviene separar «extraído», «validado», «aprobado» y «registrado». Así, un panel o un aviso puede mostrar dónde está detenido cada documento sin obligar a revisar logs técnicos.
Tip técnico: guarda el identificador del documento, la versión del extractor, el esquema utilizado, los valores propuestos, las correcciones humanas y la respuesta del sistema de destino. Esa trazabilidad permite investigar errores y probar cambios sin discutir qué versión hizo qué.
Confianza y evidencia no significan lo mismo
Una puntuación de confianza representa la estimación de un sistema, no una garantía. Debe calibrarse contra resultados reales. La evidencia de origen responde a otra pregunta: qué zona o fragmento del documento respalda el valor extraído. Mostrar ambos elementos a la persona revisora acelera la comprobación y reduce el riesgo de aceptar datos plausibles que no estaban en el archivo.
La Agencia Española de Protección de Datos publicó el 21 de julio de 2026 una nota técnica sobre exactitud, idoneidad y calidad de los datos en tratamientos con IA. Entre otras cuestiones, señala que la evaluación no puede quedarse en los datos de entrada: hacen falta métricas objetivas sobre la calidad de los resultados. También relaciona la calidad con la finalidad concreta y recuerda los principios de exactitud y minimización cuando hay datos personales.
Esto no convierte cada automatización documental en un proyecto jurídico complejo. Sí aconseja definir qué información es necesaria, quién puede verla, cuánto tiempo se conserva y cómo se corrige. Un sistema que copia todas las páginas a varios proveedores «por si acaso» puede ser técnicamente cómodo y operativamente difícil de justificar.
Tip técnico: prueba con un conjunto separado del usado para ajustar instrucciones o ejemplos. Incluye escaneos torcidos, fotografías, campos vacíos, plantillas antiguas, duplicados y documentos fuera de alcance. Si todas las muestras son perfectas, la prueba mide la demo, no el proceso.
Un ejemplo claro: partes de trabajo mezclados
Supongamos, como ejemplo hipotético y no como caso de cliente, que un equipo recibe partes de varios proveedores. Unos llegan en PDF, otros como foto y algunos incluyen varias intervenciones en el mismo archivo. El objetivo no debería ser «leer partes con IA», sino registrar cada intervención con su referencia, fecha, ubicación, materiales, observaciones y estado de firma.
El flujo puede separar páginas, clasificar el modelo de parte, extraer los campos, consultar si la referencia existe y comprobar reglas básicas. Si falta la firma, la ubicación no coincide o un campo crítico tiene baja confianza, crea una tarea de revisión. Tras aprobarla, envía los datos a la aplicación y conserva un enlace al original.
La solución valiosa no es el lector aislado. Es que una persona vea solo los casos que necesitan criterio, pueda corregirlos y deje una evidencia de por qué se registraron así. Si el proveedor cambia su plantilla, las métricas por tipo de documento deberían mostrar la degradación antes de que se acumule trabajo incorrecto.
Cuándo basta una solución interna sencilla
No todo archivo necesita IA ni una integración a medida. Si llegan pocos documentos al mes, todos utilizan la misma plantilla y la copia manual lleva unos minutos, una carpeta ordenada, un formulario y una hoja con validaciones pueden ser suficientes. También puede bastar un script pequeño si los archivos contienen texto estructurado y el destino admite una importación CSV estable.
El servicio suele tener más sentido cuando hay volumen repetitivo, formatos variables, varios canales de entrada, campos que requieren interpretación o necesidad de registrar los datos en otro sistema. También cuando la revisión manual existe pero hoy no deja trazabilidad o consume tiempo buscando el fragmento que originó cada valor.
No compensa automatizar un proceso que cambia cada semana, que nadie ha definido o en el que casi todos los documentos requieren una decisión especializada. En esos casos puede ser mejor ordenar primero el procedimiento, reducir formatos o mejorar la plantilla de origen. La automatización amplifica un proceso; no reemplaza su definición.
Cómo encaja AI Connect Docs
AI Connect Docs permite leer y extraer información estructurada de documentos. En The Black Box Lab podemos valorar esa capacidad como parte de un flujo más amplio: recepción, clasificación, validación, revisión e integración con los sistemas existentes. El alcance depende de los tipos de archivo, las reglas y las opciones de conexión disponibles.
Para un circuito centrado en facturas, ya explicamos cómo llevar datos documentales al ERP con controles. Si el problema está en conectar correo, hojas y aplicaciones, puedes consultar también nuestra guía sobre integraciones sin copiar y pegar. Este enfoque es diferente: empieza por un archivo documental mezclado y por la necesidad de convertirlo en datos revisables y trazables.
Un piloto razonable utiliza una muestra representativa, define qué errores son tolerables, mide resultados por campo y confirma cuánto trabajo humano permanece. Solo después se decide si ampliar el flujo. No prometemos que cualquier documento pueda procesarse sin revisión ni que la misma configuración sirva para todas las plantillas.
Tip técnico: antes de automatizar, crea una tabla con cada campo y cuatro columnas: fuente exacta, regla de validación, impacto de un error y responsable de revisión. Esa tabla suele revelar si necesitas IA, una regla convencional o simplemente mejorar el formulario de entrada.
Fuentes
- Microsoft Learn: novedades de Content Understanding, actualizaciones de agosto y septiembre de 2026.
- Microsoft Learn: visión general de Content Understanding.
- Microsoft Learn: buenas prácticas, confianza y revisión humana, 10 de agosto de 2026.
- OpenAI API: salidas estructuradas y sus límites.
- AEPD: Exactitud, idoneidad y calidad de los datos en tratamientos de datos personales con Inteligencia Artificial, 21 de julio de 2026.
Deja una respuesta